AI 변화 노트 2026년 10월 22일 AI 비용·검색·권한 관리에서 달라진 7가지
AI가 접근할 파일과 도구를 관리하는 설계, 문서 검색 부담을 줄이는 모델, 실행 비용 절감 실험 등 7개 소식을 쉽게 설명합니다. 발표자의 핵심 수치와 실험 조건, 원문 이미지도 함께 살펴봅니다.
오늘은 AI 사용 비용을 줄이고, 필요한 문서를 찾고, 작업 권한을 관리하는 소식을 모았습니다. 모델을 선택하는 방법부터 로봇·시설의 가상 실험까지 7개 흐름으로 살펴봅니다.
자료 확인 기준: 2026년 10월 22일 14시 1분, 한국 시각. 직전 72시간의 발표를 모은 검토용 원고입니다.
먼저 보는 7가지
약 2분 · 7개 흐름 · 자세히 읽기 약 23분
- OpenShell은 AI가 접근할 파일과 도구의 범위를 관리합니다. 도구를 써서 업무를 처리하는 AI 에이전트가 정해진 범위 안에서 일하도록 돕는 설계안입니다.
- Google Cloud에서 OpenAI 모델을 선택하는 길이 생깁니다. 현재는 선정된 일부 기업만 시험 사용할 수 있고, 사용료를 기존 클라우드 청구에 묶는 방식을 제시했습니다.
- Bekko는 문서 검색의 계산 부담을 줄이려는 모델입니다. 글을 검색용 숫자로 바꾸는 과정을 단순화했습니다. 제작자 시험에서는 검색 과제에 따라 유리한 방식이 달랐습니다.
- VocabX는 반복 표현을 묶어 AI 채점 비용을 줄였습니다. 특정 채점기 시험에서 비용이 77% 줄었지만, 다른 서비스의 요금에도 그대로 적용되는 수치는 아닙니다.
- Nemotron은 문서를 더 잘 찾아 답변 비용을 줄이는 실험입니다. 문서 찾기·순위 매기기·내용 추출을 나눠 측정했고, 특정 조합에서 에이전트 토큰 비용이 약 14% 줄었습니다.
- SimReady Central은 가상 실험용 3D 자료를 모은 곳입니다. 2천 개 이상 자료에서 모양뿐 아니라 무게·마찰 등 어떤 정보를 갖췄는지도 살펴봅니다.
- 추가 업데이트는 AI 시설의 가상 설계와 장비 사전 조립입니다. 디지털 트윈은 가상 공간에서 설계를 검토하고, DSX POD는 여러 장비를 공장에서 미리 통합하는 접근입니다.
숫자와 배경
주요 키워드: 작업 권한 · 모델 선택 · 가벼운 문서 검색 · 반복 표현 압축 · 가상 실험
- 77.0% 비용 감소 — 같은 시험에서 기존 비용을 100으로 놓으면 약 23으로 줄었다는 뜻입니다. 이해를 돕는 비율 환산이며 실제 이용 요금표는 아닙니다. VocabX의 RTX 5090·vLLM(모델 실행 소프트웨어)·동일 500요청 채점기 시험 결과입니다. 근거
- 43.76 대 32.29 — 관련 있는 문서를 검색 결과의 위쪽에 얼마나 잘 배치했는지 평가한 점수입니다. Bekko 제작자의 MNanoBEIR 시험이며, nDCG@10이라는 지표에 100을 곱했습니다. 정답률 43.76%를 뜻하지 않습니다. 근거
- 약 14% 에이전트 토큰 비용 감소 — NVIDIA의 특정 검색·재정렬 조합에서 AI가 답변 과정에 사용하는 토큰의 비용이 줄었습니다. 토큰은 AI가 글을 처리하는 단위입니다. 검색·재정렬 장비까지 합친 총운영비 절감률은 아닙니다. 근거
- 2천 개 이상 3D 자료 — SimReady Central이 소개한 가상 실험용 자료 수입니다. 각 자료가 갖춘 물리 정보와 이용 조건은 따로 확인해야 합니다. 근거
비용을 줄이는 방법은 작업 단계마다 다릅니다. VocabX는 AI가 글을 쪼개 처리하는 방식을 바꾸고, 검색 모델은 답변에 필요한 문서를 찾는 방식을 바꿉니다. OpenShell은 AI가 어떤 파일과 도구에 접근할 수 있는지를 다룹니다. 로봇·시설의 가상 실험에는 준비된 3D 자료와 엔지니어의 검토도 필요합니다. 이 연결은 이번 발표를 묶어 읽은 편집 해석입니다. 서로 다른 시험의 절감률을 더해 전체 비용 절감률로 계산할 수는 없습니다.
시간 흐름
아래는 원문에서 확인한 게시 시각을 한국 시각(KST)으로 바꾼 기록입니다. Google Cloud의 날짜 표시 차이는 뒤의 ‘취재와 확인 기록’에 정리했습니다.
- 10/21 11:23 KST · 게시 — Bekko 제작자가 정적 임베딩 평가를 공개했습니다.
- 10/21 18:35 KST · 게시 — NVIDIA가 DSX POD 참조 설계를 설명했습니다.
- 10/21 18:38 KST · 게시 — NVIDIA가 에이전트를 이용한 AI 공장 디지털 트윈 작업 절차를 소개했습니다.
- 10/21 18:50 KST · 게시 — NVIDIA가 OpenShell 참조 아키텍처를 설명했습니다.
- 10/21 19:41 KST · 게시 — NVIDIA가 Nemotron 3.5 검색·재정렬·추출 모델군을 소개했습니다.
- 10/21 19:59 KST · 게시 — NVIDIA가 SimReady Central을 소개했습니다.
- 10/22 02:35 KST · 게시 — Dharma-AI가 VocabX의 비용 실험을 공개했습니다.
- 10/22 04:02 KST · 게시 시각 표시 — Google Cloud의 OpenAI 모델 발표입니다. 본문에는 10월 21일로 표시돼 있어 두 기록을 함께 남겼습니다.
1 OpenShell은 AI가 접근할 파일과 도구의 범위를 관리합니다
- NVIDIA는 AI 에이전트의 파일·도구 접근을 제한하는 참조 설계, 즉 시스템을 만들 때 참고할 설계안을 소개했습니다.
- AI가 일하는 공간과 접근 권한을 관리하는 장치를 나눕니다.
- 소프트웨어로 접근을 제한하고, 필요하면 별도 하드웨어의 관찰·보호 기능을 더하는 구조입니다.
원문 요약
AI가 파일을 읽거나 외부 도구를 사용할 때, 허용된 범위를 벗어나지 않도록 실행 환경에서 접근을 제한하는 설계입니다. NVIDIA의 OpenShell은 AI가 작업하는 공간과 권한을 관리하는 장치를 나눕니다. 모델에게 규칙을 알려주는 것과 별개로, 시스템이 실제 접근을 제한하도록 구성합니다.
그림 1. NVIDIA OpenShell 발표의 원문 대표 일러스트. 관찰·기록·보호를 표현한 공식 일러스트이며 실제 설치 화면이나 세부 아키텍처도는 아닙니다. 출처: NVIDIA 원문. 원본 확대
구성 요소는 네 가지입니다. Gateway는 작업 공간의 생성·종료와 규칙을 관리합니다. Supervisor는 외부 요청과 인증 정보 접근을 중재합니다. Sandbox는 파일과 실행 중인 프로그램의 접근을 제한합니다. Policy prover는 규칙이 조직의 허용 상한을 넘는지 점검합니다.
기존 조직의 신원 확인·인가·감사 체계도 연결할 수 있습니다. 인가는 ‘누구인지 확인한 뒤 어떤 행동까지 허용할지 정하는 것’이고, 감사는 작업 기록을 살펴보는 절차입니다. 참조 설계에서는 Vera CPU가 작업을 처리합니다. 선택적 하드웨어 보호로 BlueField-4의 별도 영역에 있는 Sentry가 추가 관찰과 정책 집행을 맡습니다. 이번 발표는 참고할 설계 구조를 설명하며, 특정 회사에 구축해 검증을 마쳤다는 사례는 아닙니다.
함께 볼 내용: 원문의 Vera 처리 속도 수치는 특정 비교 환경의 별도 결과입니다. 작업이 빠른지와 접근 제한이 제대로 작동하는지는 각각 확인해야 합니다.
핵심내용: AI가 읽어도 되는 폴더, 사용할 도구, 연결할 외부 서비스를 먼저 적어 보세요. 실행 환경이 그 범위를 실제로 제한하는지와 AI가 규칙을 바꿀 수 있는지 확인하는 것이 출발점입니다.
#OpenShell #에이전트권한 #실행환경
근거 자료 1건 · 기업 공식 기술 글 · 참조 아키텍처
2 Google Cloud에서 OpenAI 모델을 선택합니다, 일부 기업부터 시험 제공합니다
- Google Cloud가 자사 플랫폼에서 OpenAI 모델을 선택하고 사용하는 경로를 발표했습니다.
- 현재는 선정된 일부 기업만 사용할 수 있는 비공개 프리뷰, 즉 제한된 시험 제공 단계입니다.
- 데이터 비보관(ZDR)과 처리 중 데이터 보호(Confidential Compute)는 추후 제공 항목입니다.
원문 요약
Google Cloud 고객이 여러 회사의 AI 모델을 한 플랫폼에서 골라 쓸 수 있도록 OpenAI 모델을 추가한다는 발표입니다. model garden은 이런 모델 선택 목록과 실행 경로를 뜻합니다. 소개한 모델은 GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna입니다. 작업에 필요한 품질·응답 속도·비용을 비교해 모델을 고르는 방향을 제시합니다.
그림 2. Google Cloud의 OpenAI 모델 제공 발표 대표 일러스트. 제공 사실을 알리는 발표 대표 이미지이며 실제 콘솔 화면이나 성능 비교표는 아닙니다. 출처: Google Cloud 원문. 원본 확대
모델 사용은 Google Cloud Marketplace를 통해 거래하고, 사용료를 기존 클라우드 청구서와 이용 약정에 연결한다고 설명합니다. 누가 사용하는지 확인하는 신원 관리, 작업 기록을 남기는 감사, 데이터 접근 범위를 정하는 기능도 공통 운영 체계로 묶는다는 내용입니다.
현재는 일부 기업 대상 시험 제공입니다. API(다른 프로그램에서 모델을 호출하는 연결 방식)와 로컬 Codex 작업 흐름의 연결도 안내합니다. ZDR은 데이터를 보관하지 않는 옵션, Confidential Compute는 처리 중인 데이터를 보호하는 기능을 뜻하며 둘 다 추후 제공입니다. Gemini for business와 Antigravity 연결도 예고 단계입니다. 모델을 제공하는 경로가 바뀌어도 응답 품질·가격·기능이 모두 같다는 비교 시험을 제시한 것은 아닙니다.
함께 볼 내용: 지금 계정에서 쓸 수 있는 기능과 나중에 제공될 기능을 나눠 확인하세요. 발표된 모델 이름만으로 자신의 계정에서 바로 사용할 수 있다고 판단하기는 어렵습니다.
핵심내용: 기존 클라우드 청구에 모델 사용료를 묶을 수 있다는 점이 운영상의 변화입니다. 도입 전에는 계정의 시험 사용 자격과 데이터 처리 조건을 확인하고, 같은 업무로 품질·속도·비용을 비교하세요.
#GoogleCloud #모델선택 #비공개프리뷰
근거 자료 1건 · 기업 공식 발표 · 일부 기업 비공개 프리뷰
3 Bekko는 문서 검색의 계산 부담을 줄이는 가벼운 모델입니다
- 문서 검색에 쓸 숫자 정보를 만드는 계산을 단순화했고, CPU에서 처리할 수 있다고 설명합니다.
- 제작자의 한 검색 평가에서 Bekko는 43.76점, 비교한 다국어 정적 모델은 32.29점이었습니다.
- 단어 일치 검색이나 문맥을 살피는 모델이 더 나은 과제도 있었습니다.
원문 요약
Bekko는 문서 검색에 쓸 숫자 정보를 만드는 과정을 가볍게 만든 모델입니다. 글의 특징을 숫자 묶음(벡터)으로 표현하는 방법을 ‘임베딩’이라고 합니다. 제작자 Yuichi Tateno의 bekko-static-embedding-v1은 글 조각인 토큰마다 정해진 벡터를 찾아 평균을 냅니다. 이를 정적 임베딩이라고 하며, 주변 문맥을 분석하는 Transformer 층을 실행하지 않아 CPU에서 처리할 수 있습니다.
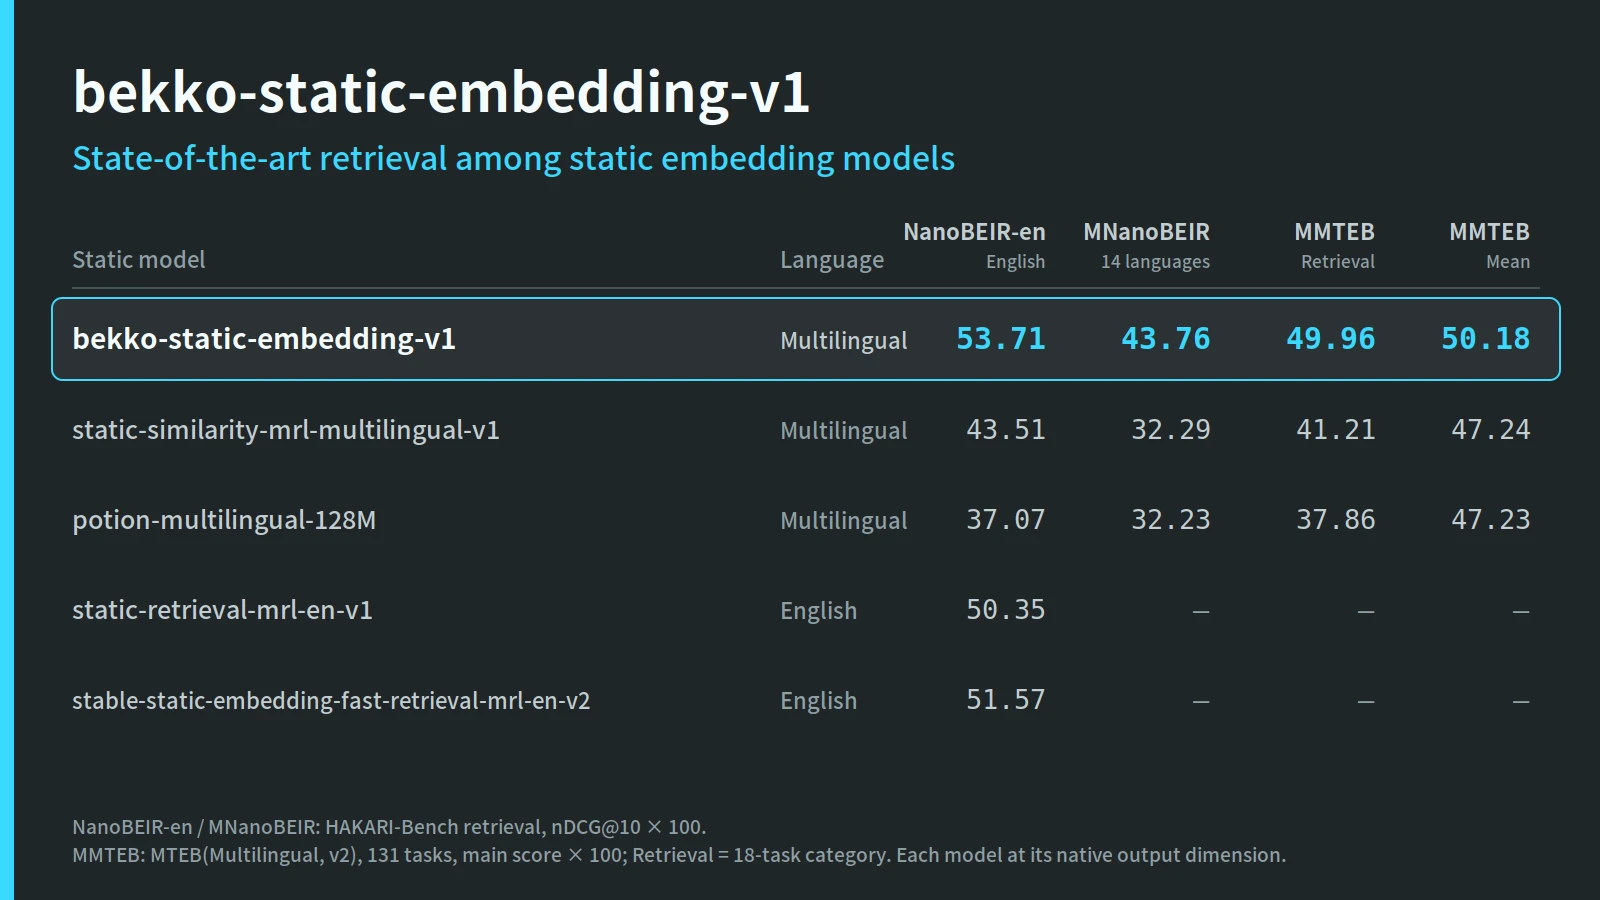
그림 3. Bekko 제작자가 공개한 정적 임베딩 검색 평가표. 검색 점수와 평가 묶음이 다른 열을 구분해 읽어야 합니다. 제작자 평가표이며 독립 재현 결과는 아닙니다. 출처: Yuichi Tateno 원문. 원본 확대
도표 읽는 법: 같은 평가 열에서 모델별 점수를 비교하세요. 점수가 높을수록 관련 문서를 위쪽에 잘 배치했다는 뜻입니다. nDCG@10에 100을 곱한 값이며 정답률은 아닙니다.
| 검색 평가 | Bekko | 비교 대상 |
|---|---|---|
| MNanoBEIR: 14개 언어·13개 과제 | 43.76 | 32.29: 다국어 정적 모델 |
| MMTEB의 검색 범주 | 49.96 | 50.9: 문맥형 multilingual-e5-small |
학습에는 40개 언어의 약 8억 1,400만 문장 쌍과 20만 토큰 어휘를 썼다고 설명합니다. BM25는 단어 일치를 활용하는 검색 방식인데, 37개 평가 묶음 중 21개 평균에서 이 정적 모델을 앞섰습니다. 벡터 길이를 줄이면 메모리·저장량뿐 아니라 점수도 달라집니다. 제작자는 평가 도구 HAKARI-Bench도 개발하며, 위 결과는 제작자가 제시한 평가입니다.
함께 볼 내용: 서로 다른 평가의 점수를 한 줄로 묶어 우열을 정하지 마세요. 전체 과제 평균과 다른 검색 묶음에서는 문맥형 모델과의 차이가 남았고, 한국어 업무 문서에서의 결과도 직접 확인해야 합니다.
핵심내용: 같은 문서와 질문으로 단어 일치 검색(BM25), 정적 임베딩, 작은 문맥형 모델을 비교해 보세요. 필요한 문서를 잘 찾는지와 실제 처리 시간·비용을 함께 기록하면 선택하기 쉽습니다.
#Bekko #정적임베딩 #검색평가
근거 자료 1건 · 제작자 원문 · 자체 평가와 비교 자료
4 VocabX는 반복 표현을 묶어 AI 채점 비용을 줄인 실험입니다
- Dharma-AI는 채점기에 자주 나오는 표현과 출력 형식에 맞춰 AI의 어휘를 다시 구성했습니다.
- Qwen3-4B 시험에서 평균 응답은 350→101토큰, 측정 실행 비용은 77.0% 줄었습니다. 토큰은 AI가 글을 처리하는 단위입니다.
- RTX 5090·vLLM·동일 500요청을 사용한 실측이며, 소개 논문은 심사 중입니다.
원문 요약
같은 평가 문구를 반복해 쓰는 AI 채점기에서, 글을 더 적은 조각으로 처리하도록 어휘를 바꾼 실험입니다. Dharma-AI는 포르투갈어 에세이 채점기를 대상으로 VocabX를 소개했습니다. 반복 문구와 JSON(항목 이름과 값을 짝지은 데이터 형식)이 여러 토큰으로 나뉘는 문제를 다룹니다. 자주 쓰는 표현뿐 아니라 입력과 출력 중 어느 쪽의 비용을 줄일지도 고려해 어휘를 다시 묶습니다.
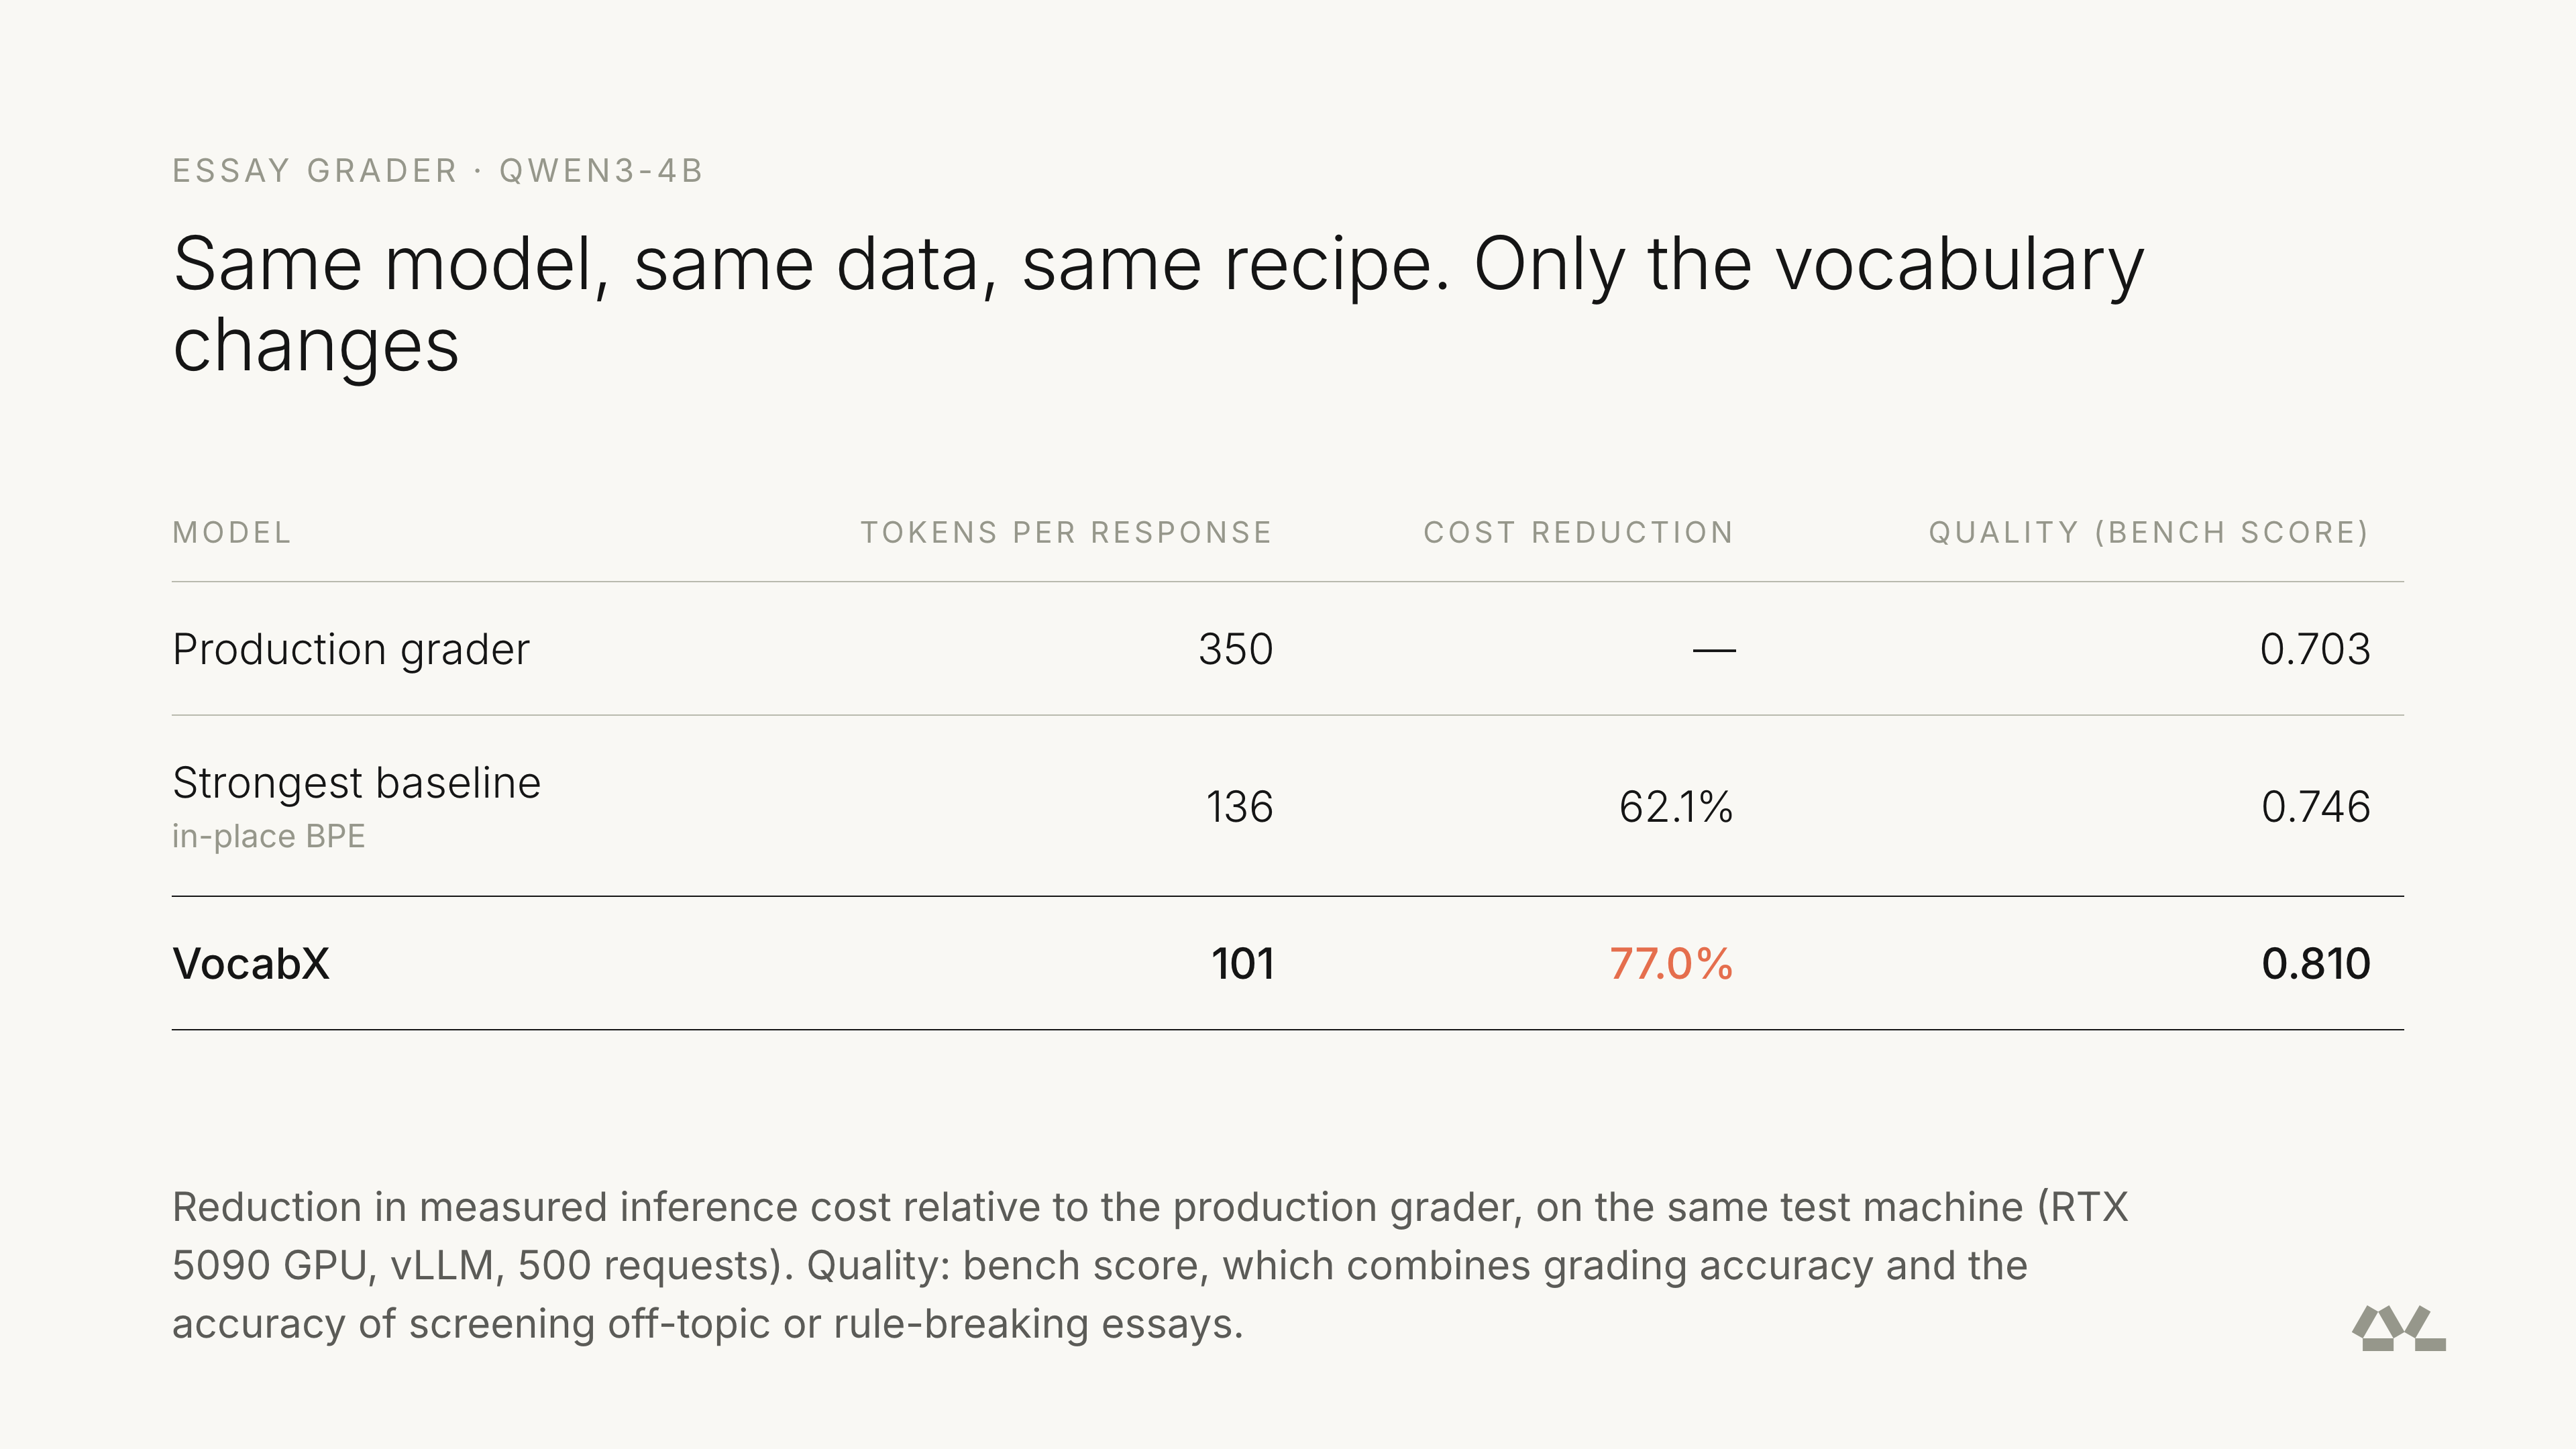
그림 4. VocabX의 에세이 채점기 비용과 품질 비교 도표. 같은 장비의 500요청에서 실행 시간으로 계산한 비용과 별도 품질 지표를 함께 보여줍니다. 출처: Dharma-AI 원문. 원본 확대
도표 읽는 법: VocabX 행의 응답 길이 101토큰, 비용 감소 77.0%, 품질 점수 0.810을 함께 보세요. 응답 길이·비용·품질은 서로 다른 지표입니다.
| 비교 항목 | 기존 채점기 | VocabX |
|---|---|---|
| 평균 응답 길이 | 350토큰 | 101토큰 |
| 실행 비용 | 비교 기준 | 77.0% 감소 |
| 채점·규칙 위반 판별을 묶은 bench score | 0.703 | 0.810 |
기본 모델·데이터·학습 방법을 맞추고, 무작위 처리에 쓰는 설정인 난수 조건도 같게 했습니다. 토크나이저(글을 토큰으로 나누는 장치)가 다른 채점기 7개를 학습한 뒤, 같은 RTX 5090과 vLLM에서 동일한 500요청을 실행하고 실제 실행 시간으로 비용을 계산했습니다. 초기안은 점수 결정까지 한 토큰으로 묶어 품질이 나빠졌고, 점수를 따로 남긴 수정이 효과적이었다고 설명합니다. 기존 API의 설정만 바꾼 결과가 아니며, 심사 과정에서 수치가 바뀔 수 있습니다.
함께 볼 내용: 77% 감소는 이 채점기의 시험 조건에서 나온 결과입니다. 다른 업무·언어·모델에 그대로 적용할 수 없고, 입력·출력 길이와 실행 장비에 따라서도 비용이 달라집니다.
핵심내용: 반복 응답이 많은 자체 운영 모델이라면 어휘를 바꾸는 실험을 검토할 수 있습니다. 응답이 짧아진 뒤에도 점수·분류·필수 출력 항목이 유지되는지 확인하고, 재학습 비용과 실행 비용을 따로 계산하세요.
#VocabX #토크나이저 #추론비용
근거 자료 1건 · 제작 기업 원문 · 자체 실측 · 심사 중 연구 소개
5 Nemotron은 문서를 더 잘 찾아 AI 답변 비용을 줄이는 실험입니다
- NVIDIA는 문서 찾기, 검색 결과의 순위 매기기, 표·차트 내용 추출을 각각 맡는 모델을 소개했습니다.
- 특정 8B 검색·재정렬 조합에서 질문당 에이전트 토큰 비용이 약 14% 줄었다고 보고했습니다.
- H100의 문서 추출 시험에서는 처리 횟수를 늘릴 때 평가 점수와 초당 처리량이 함께 달라졌습니다.
원문 요약
AI가 문서를 반복해서 뒤지는 일을 줄이기 위해, 답변에 필요한 근거를 찾는 과정을 나눠 개선한 발표입니다. NVIDIA의 Nemotron 3.5에서 Embed는 글·문서 이미지를 검색용 숫자 정보로 바꿉니다. Rerank는 찾아낸 문서를 질문과 다시 비교해 순위를 매깁니다. 이를 재정렬이라고 합니다. Parse는 페이지의 글·표·차트를 구조화된 글과 표로 추출합니다.
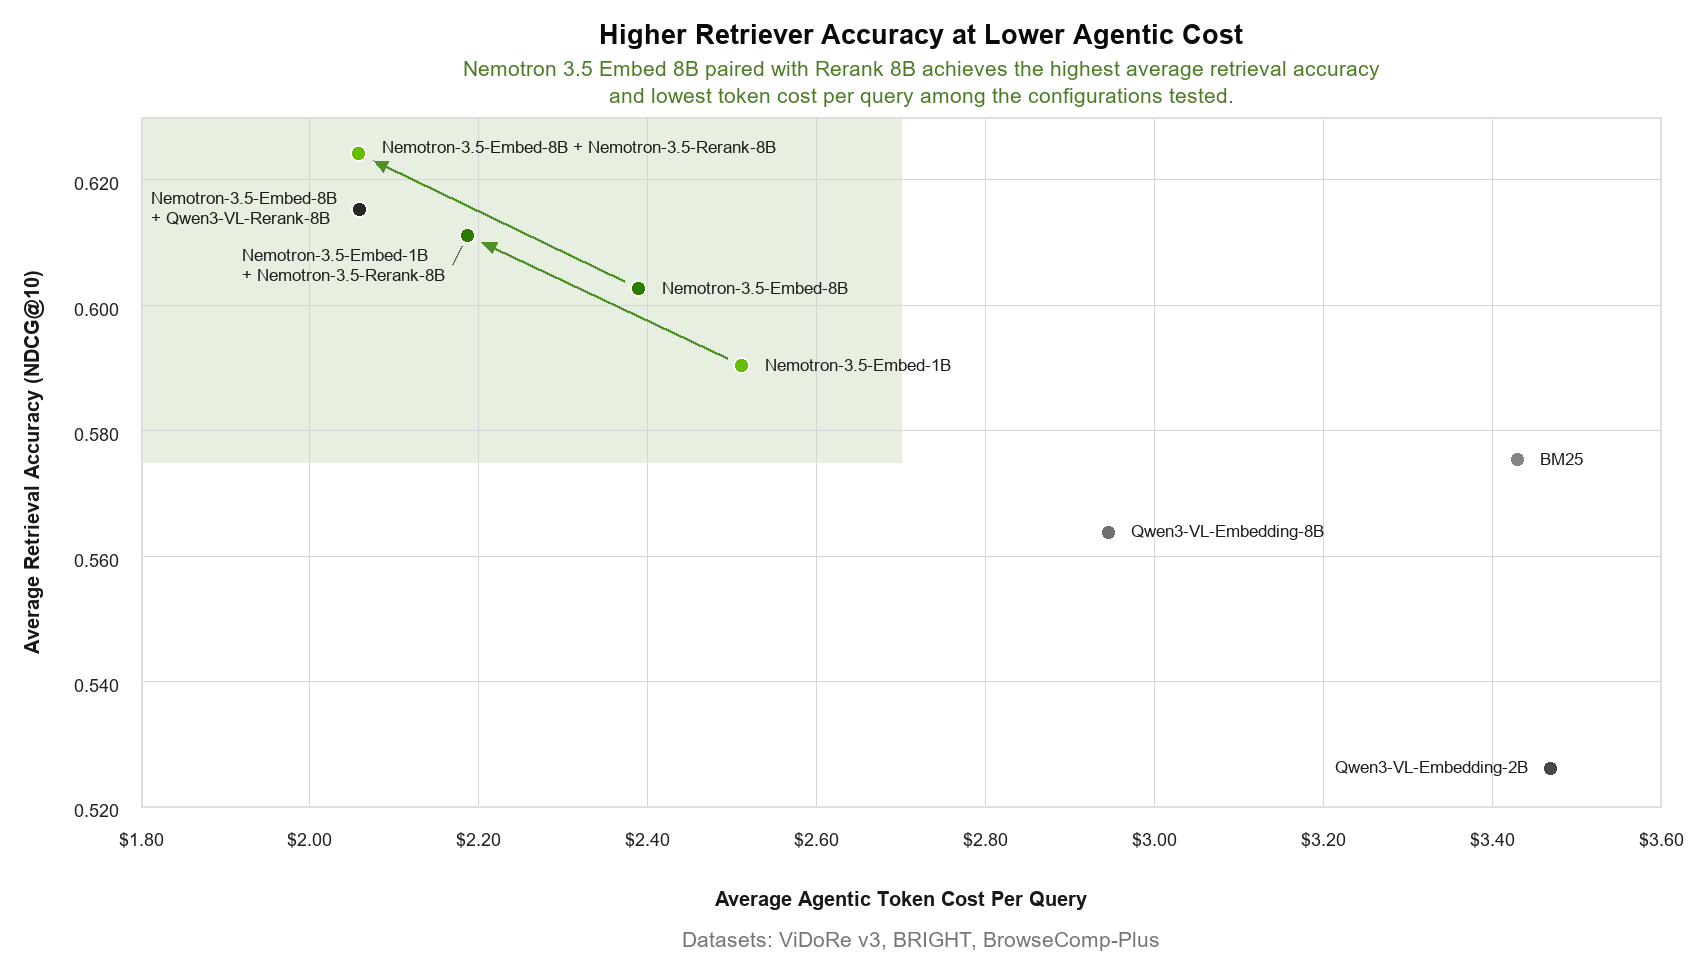
그림 5. Nemotron 3.5 검색 모델의 원문 평가 도표. 가로축은 질의당 에이전트 토큰 비용, 세로축은 검색 관련성 점수입니다. 전체 인프라 비용의 비교가 아닙니다. 출처: NVIDIA 원문. 원본 확대
도표 읽는 법: 가로축은 질문 하나당 에이전트 토큰 비용, 세로축은 관련 문서를 잘 찾았는지 나타내는 점수입니다. 같은 평가 묶음 안에서 비용과 품질을 함께 비교하세요.
ViDoRe v3·BRIGHT·BrowseComp-Plus 시험에서 8B Embed에 8B Rerank를 추가한 조합은 재정렬이 없는 경우보다 에이전트 토큰 비용이 약 14% 낮았습니다. 8B는 모델 규모를 나타내는 표기입니다. 이 수치는 검색 장비와 재정렬 실행을 합친 총운영비 절감률은 아닙니다.
약 6억 3,100만 매개변수의 Parse는 H100 GPU 한 대에서 다음 결과를 제시했습니다. 매개변수는 모델의 계산에 쓰이는 내부 값입니다.
| 페이지 처리 횟수 | 초당 처리량 | 평가 점수 |
|---|---|---|
| 한 번 | 16.1쪽 | 72.74 |
| 세 번 | 10.5쪽 | 75.20 |
복잡한 영역을 다시 읽으면 점수와 처리 속도가 함께 달라집니다. 순위 수치는 특정 평가 자료와 10월 20일 기준표의 결과이며, 모든 문서·언어에서 같은 성능을 보장하지 않습니다. 위 수치는 공급사 시험 결과이고 이번 작성에서 재현하지 않았습니다.
함께 볼 내용: 답변에 쓰는 토큰이 줄어도 문서 검색과 순위 매기기에 추가 계산이 들 수 있습니다. VocabX의 토큰화 실험과도 대상·조건이 달라 절감률을 합칠 수 없습니다.
핵심내용: 문서 추출 → 검색 → 순위 매기기 → 답변 생성으로 나눠 시간과 사용 자원을 적어 보세요. 어느 단계에서 줄인 비용이 다른 단계의 추가 비용보다 큰지 확인해야 도입 효과를 판단할 수 있습니다.
#Nemotron #문서검색 #에이전트비용
근거 자료 1건 · 기업 공식 기술 글 · 자체 평가
6 SimReady Central은 로봇·시설의 가상 실험용 3D 자료를 모은 곳입니다
- NVIDIA는 Hugging Face에 로봇과 AI 시설용 3D 자료 2천 개 이상을 소개했습니다.
- 모형의 생김새뿐 아니라 충돌·무게·마찰 또는 설비 관련 정보를 확인할 수 있습니다.
- 자료마다 지원하는 용도와 정보가 달라, 쓰려는 실험에 필요한 속성이 있는지 확인해야 합니다.
원문 요약
가상 공간에서 로봇이나 시설을 시험할 때 쓸 3D 모형과 관련 정보를 모아놓은 라이브러리입니다. NVIDIA의 SimReady Central은 로봇 팔·그리퍼(물건을 집는 장치)·창고 장비부터 랙·냉각 설비까지 2천 개 이상 자산을 소개했습니다. 여기서 자산은 3D 모형과 연결된 정보를 뜻합니다. 여러 3D 자료를 한 장면으로 조합하는 OpenUSD를 사용합니다.
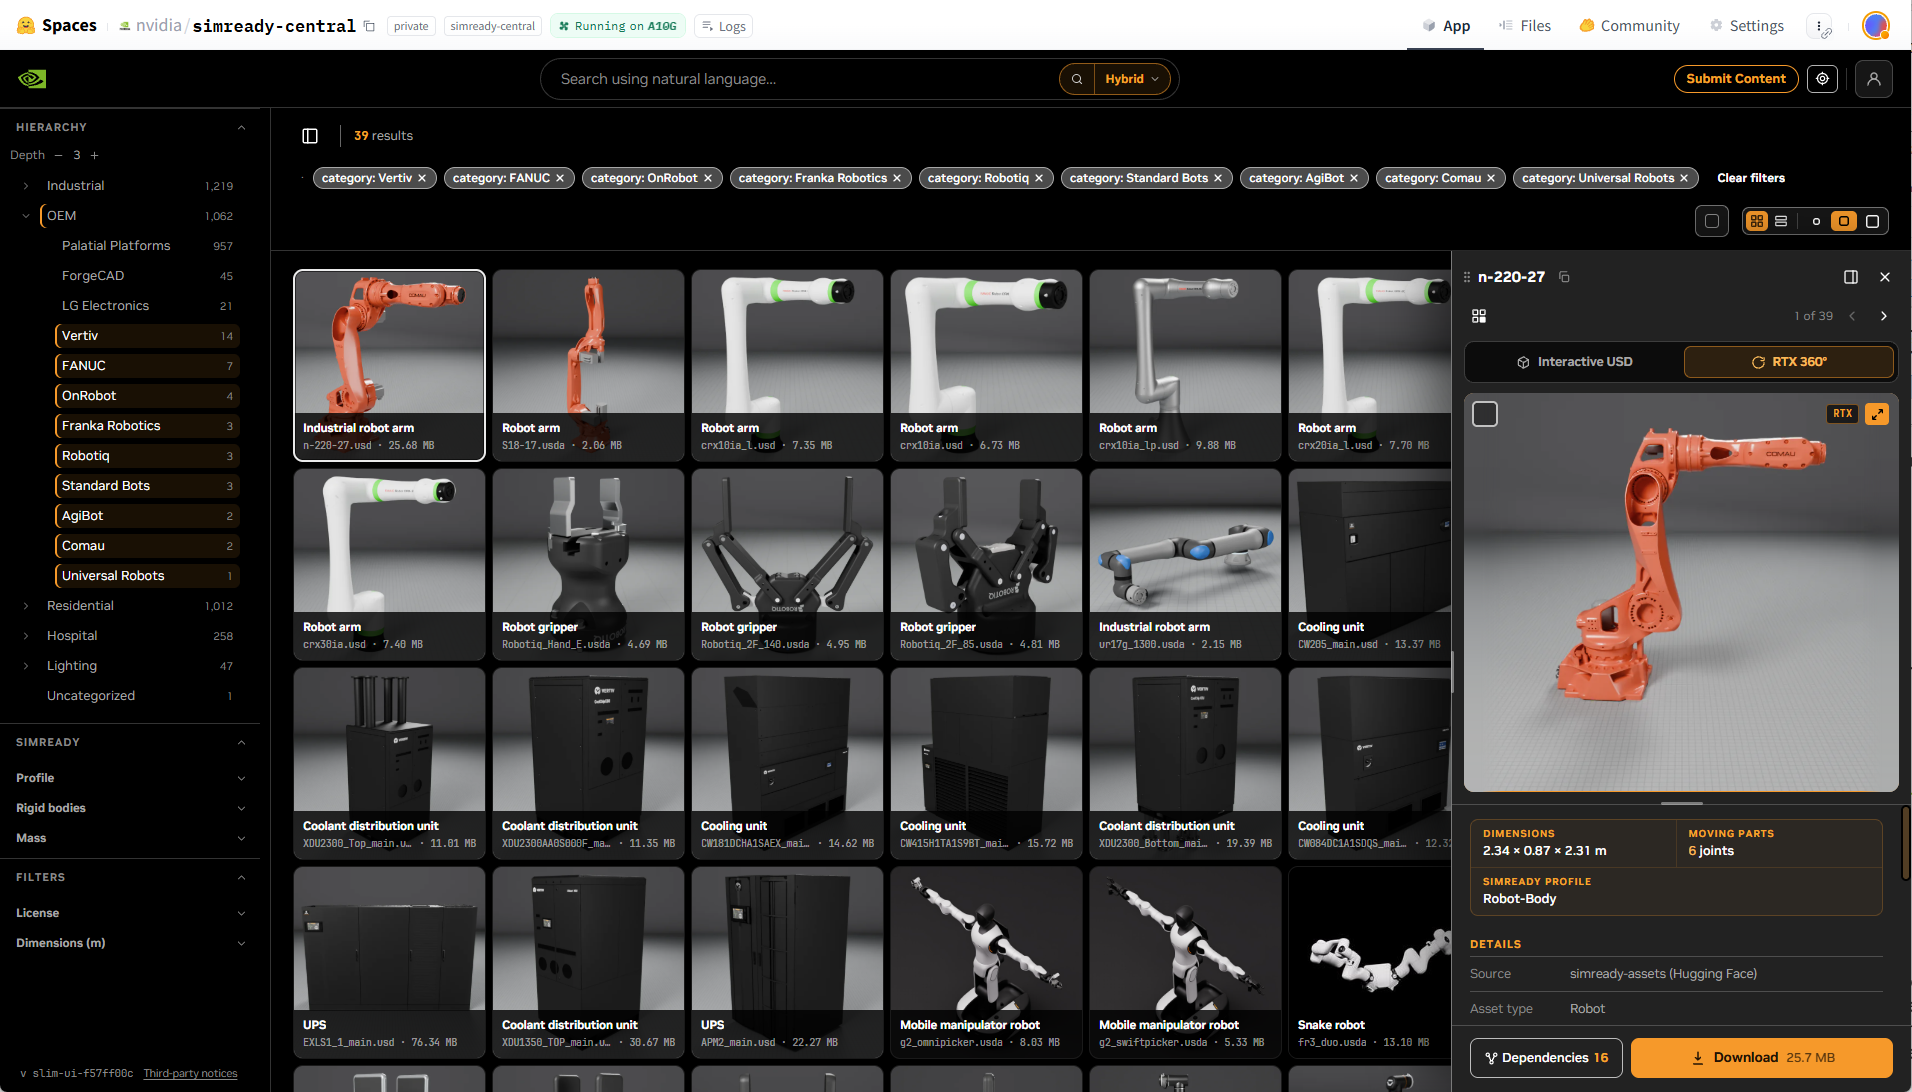
그림 6. SimReady Central 원문에 실린 라이브러리 화면 예시. 발표자 환경의 자산 검색·속성 화면 예시이며 이번 원고에서 접속한 사내 서비스 화면이 아닙니다. 출처: NVIDIA 원문. 원본 확대
로봇이 물건을 집는 실험에는 충돌 형태·질량(무게와 관련된 물리량)·마찰이 필요합니다. AI 공장처럼 AI를 학습·실행하는 대규모 컴퓨팅 시설을 분석할 때는 장비의 전기·열 관련 정보가 필요할 수 있습니다. 모형이 비슷하게 생겼어도 이런 정보가 없으면 원하는 실험에 쓰기 어렵습니다.
SimReady Foundation은 용도별 프로필, 즉 필요한 정보와 지원 기능의 목록 및 검증 도구를 제공합니다. 개발자는 자료마다 지원하는 기능을 확인해 여러 공급자의 장비를 조합하고, 제조사는 자신의 자료를 준비·검증해 제공하는 구조입니다. 모든 자료가 모든 용도를 지원하는 것은 아닙니다. 실험이 실제를 얼마나 충실하게 반영하는지는 포함된 정보와 적용 조건에 달려 있습니다. 무료로 접근할 수 있다는 설명과 개별 자료의 이용 조건도 따로 확인해야 합니다.
함께 볼 내용: 그림은 발표자가 공개한 라이브러리 화면 예시입니다. 화면의 자료 수나 프로필을 현재 전체 목록의 실시간 집계로 사용하지 않았습니다.
핵심내용: 가상 실험에 필요한 정보를 먼저 적어 보세요. 물건을 집는다면 충돌·질량·마찰, 시설을 비교한다면 전기·열 정보를 확인하고, 해당 3D 자료의 지원 범위와 이용 조건을 대조하면 됩니다.
#SimReady #OpenUSD #시뮬레이션자산
근거 자료 1건 · 기업 공식 기술 글 · 공개 자산 라이브러리
7 추가 업데이트 AI 시설의 가상 설계와 장비 사전 조립
- AI 공장 디지털 트윈은 실제 시설을 본뜬 가상 모델을 만들고 설계를 검토하는 작업 절차입니다.
- DSX POD는 장비를 공장에서 미리 통합하는 동안 현장 기반 시설을 준비하는 참조 설계입니다.
원문 요약
AI 공장 디지털 트윈: AI 연산 시설을 본뜬 가상 모델에서 설계를 살펴보는 작업 절차입니다. DSX Blueprint의 3D 자료와 설계 자료를 에이전트로 조합하며, 개발자가 도구와 변경을 안내하고 엔지니어가 검토합니다. 원문의 처리량 1.35배 예시는 1MW 전력·PUE 1.1을 가정한 값입니다. PUE는 시설 전체 전력을 IT 장비 전력으로 나눈 비율입니다. 이 예시는 가상 시설 모델이 직접 산출한 실측 결과가 아니라고 명시합니다.
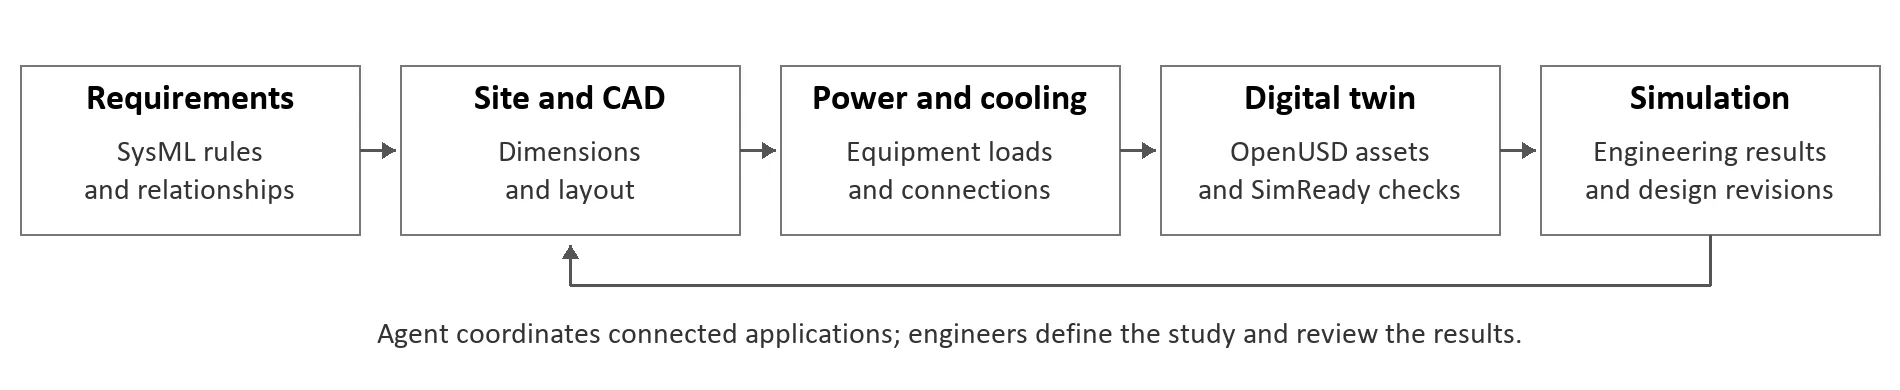
그림 7. OpenUSD 디지털 트윈에서 요구사항과 설계 검토를 연결한 원문 절차도. 요구사항에서 설계·시뮬레이션과 수정으로 이어지며 엔지니어 검토가 포함됩니다. 출처: NVIDIA 원문. 원본 확대
DSX POD: 컴퓨팅·네트워크·저장·전력·액체 냉각 장비를 컨테이너에 미리 통합하고 출하 전 검증하는 참조 설계입니다. 공장 조립과 현장 기반 시설 준비를 병행하려는 방식입니다. NVIDIA는 설계 기반을 제공하고 파트너가 제조·설치·지원을 맡는 역할을 구분합니다. 실제 부지의 준비가 끝났거나 모든 현장에서 같은 일정으로 가동된다는 뜻은 아닙니다.
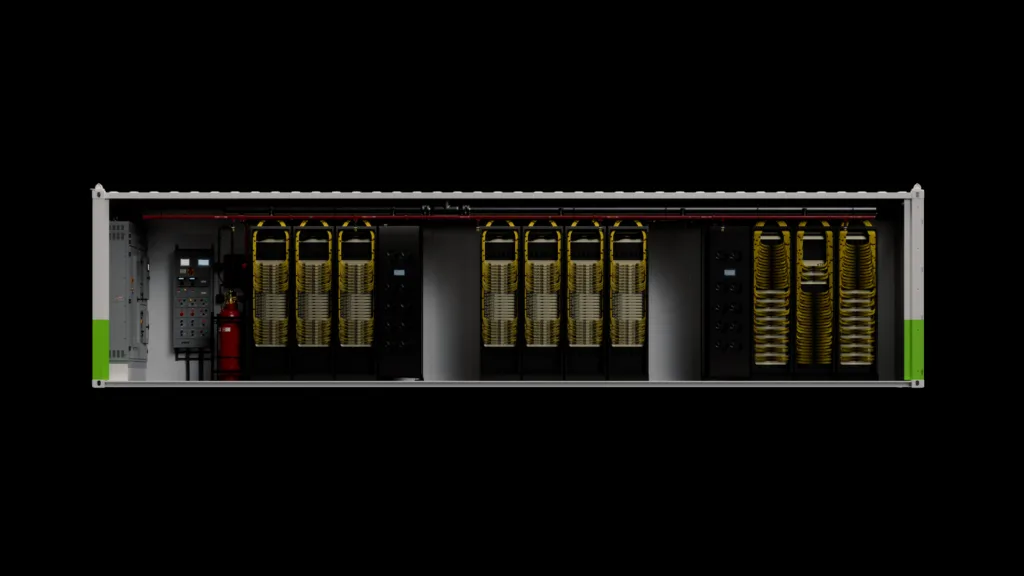
그림 8. NVIDIA DSX POD의 원문 컨테이너 구성 그림. 컨테이너의 구성을 설명하는 공식 렌더링이며 실물 완공 사진은 아닙니다. 출처: NVIDIA 원문. 원본 확대
함께 볼 내용: 가상 모델로 설계를 검토하는 일과 현장에서 장비를 설치·가동하는 일은 서로 다른 단계입니다. 그림의 작업 절차와 렌더링도 실제 현장 성능을 측정한 자료와 구분해야 합니다.
핵심내용: 3D 자료를 자동으로 조합한 뒤에도 엔지니어가 설계 조건과 물리 정보를 확인해야 합니다. 실제 현장에서는 전력·냉각·설치 준비와 장비 인수 기준까지 별도로 점검하세요.
#DSX #디지털트윈 #AI인프라
근거 자료 2건 · NVIDIA 공식 기술 글 · 참조 설계
흐름 진단
- 업무 연결 — 모델 선택과 청구, 접근 권한, 가상 실험 자료처럼 실제로 일하기 위한 조건이 구체화되고 있습니다.
- 비용 실험 — 반복 표현을 묶는 방법과 필요한 문서를 잘 찾는 방법은 서로 다른 단계의 비용을 줄이려는 접근입니다.
- 품질 확인 — 처리량과 점수가 높아졌다는 수치를 읽을 때는 비교 대상·장비·입력 자료도 함께 봐야 합니다.
- 도입 조건 — 시험 사용 자격, 데이터 처리, 파일 접근 범위, 현장 준비를 각각 확인해야 합니다.
위 진단과 아래 실무 팁은 이번 원문을 연결한 편집 해석입니다. AI 시장 전체의 변화를 측정한 통계는 아닙니다.
바로 쓰는 방법
- AI가 읽을 폴더와 사용할 도구를 적어 보세요. 업무에 필요한 파일·도구·외부 서비스의 목록을 만들고, 실행 환경이 그 범위를 실제로 제한하는지 확인합니다. 모델에게 알려준 규칙과 시스템이 막아주는 접근을 나눠 봅니다. 근거
- 모델 이름 옆에 사용 조건도 적어 두세요. 계정의 사용 자격, 시험 제공 단계, 가격, 기록 보관, 감사 기능을 함께 정리합니다. 같은 업무를 맡겨 답변 품질과 걸리는 시간을 비교하세요. 근거
- 같은 질문으로 검색 방식 세 가지를 비교하세요. 단어 일치 검색(BM25), 정적 임베딩, 작은 문맥형 임베딩에 같은 문서와 질문을 사용합니다. 필요한 문서를 위쪽에 찾았는지와 비용을 기록하고, 전체 평균과 한국어 업무에서 놓친 사례를 함께 살펴보세요. 근거
- 응답을 줄여도 점수와 분류 결과가 유지되는지 확인하세요. 변경 전후에 같은 입력을 넣고 최종 점수·분류·필수 JSON 항목을 대조합니다. 다시 학습시키는 비용과 실제 실행 비용도 따로 적습니다. 근거
- 문서 처리 비용을 단계별로 나눠 적으세요. 페이지에서 내용 추출하기, 검색하기, 순위 매기기, 답변 만들기에 든 시간과 자원을 각각 기록합니다. 답변 토큰이 줄어도 검색 계산이 늘었다면 이를 더해 총비용을 비교해야 합니다. 근거
- 3D 모형의 생김새와 실험용 정보를 함께 확인하세요. 필요한 충돌·질량·마찰 또는 전기·열 정보를 목록으로 만들고 자료의 지원 기능과 대조합니다. 이용 조건과 시뮬레이션에 필요한 정보가 갖춰졌는지도 각각 확인하세요. 근거
취재와 확인 기록
자료 조회 범위는 한국 시각 2026년 10월 19일 14시 1분 22초부터 22일 14시 1분 22초까지입니다. 이번 호 작성 때 새 검색과 공식 목록·RSS 확인, 원문 HTTP 재수집으로 후보 9건을 확보해 8건을 채택했습니다. 이 범위에 자료가 충분해 최근 7일까지 넓히지 않았습니다. 이번 수정은 당시 확인한 자료의 설명을 쉽게 다듬은 것이며, 자료 확인 기준 시각을 바꾸지 않았습니다.
출처는 기업 공식 발표와 제작자 원문입니다. 개인 제작자의 Bekko 평가와 기업 발표를 구분했고, Hugging Face는 글을 올린 플랫폼과 실제 발표자를 나눠 표시했습니다. NVIDIA 관련 발표 5건을 서로 독립된 검증 5건으로 세지 않았습니다. 성능·비용은 발표자가 제시한 조건의 결과이며 모델 실행·제품 구축·시설 시뮬레이션을 직접 재현하지 않았습니다.
원문 요약 7개는 각각 1,000자 이내이며, 7번은 두 업데이트를 합친 길이입니다. 본문 원문 이미지 8장은 출처와 원본 파일을 보존했고, 이번에 새로 생성한 이미지는 0장입니다. 원문 일러스트·예시 화면·렌더링의 성격은 그림 설명에 표시했습니다. 이미지를 수집했다는 사실만으로 공개 이용 조건이 확정되는 것은 아니며, 현재는 로컬 검토용 원고입니다.
게시일과 이미지 확인의 세부 기록
Google Cloud 글은 본문·BlogPosting의 10월 21일과 published_time 메타태그의 10월 22일 04:02:45+0900을 함께 확인했습니다. 조회 기간에는 시간대가 명시된 게시 시각을 사용하고, 본문의 날짜에 임의 시각을 붙이지 않았습니다. 후보였던 Claude Security 글은 날짜만 있고 시각·시간대가 없어 조회 범위를 보수적으로 판정하기 어려워 보류했습니다.
Bekko 제작자가 평가 도구도 개발한다는 관계, VocabX 결과가 논문 심사 중이라는 점, 비공개 프리뷰와 추후 제공 항목을 본문에 남겼습니다. Bekko 관련 글에 실린 별도 의사결정 모델 화면은 제외하고 해당 원문의 실제 평가표를 사용했습니다. 이전 시험 호의 기사·이미지를 가져와 날짜만 바꾼 원고가 아닙니다.
자료 표시 안내
- 기업 공식 발표 — 해당 기업이 직접 공개한 제품·기술 설명입니다.
- 제작자 원문 — 제작자가 공개한 방법·평가이며, 외부의 독립 검증과 구분합니다.
- 자체 평가 — 발표자가 정한 실험 조건과 비교 자료 안에서 읽어야 하는 수치입니다.
- 배포 단계 — 일부 고객 시험 제공, 추후 제공, 참고용 설계안을 구분합니다.
- 원문 게재 자료 — 원문에 실린 이미지입니다. 원문 제공자가 어떤 방식으로 그림을 제작했는지까지 확인했다는 뜻은 아닙니다.
- 편집 해석 — 여러 발표를 연결해 정리한 흐름과 실무 제안입니다.
자주 묻는 질문
Q1. VocabX에서 비용이 77% 줄었다면 내 AI 사용료도 그렇게 줄일 수 있나요?
이 수치는 특정 채점기와 장비에서 같은 500개 요청으로 측정한 결과입니다. 다른 언어·업무·API 요금에 그대로 적용할 수는 없습니다. 자신의 작업에서는 답변 품질과 실제 사용 비용을 함께 비교해야 합니다.
Q2. Nemotron의 14%와 VocabX의 77%를 더해도 되나요?
두 실험은 바꾼 기술과 비용을 계산한 범위가 다릅니다. 하나는 검색·재정렬에 따른 에이전트 토큰 비용, 다른 하나는 어휘를 바꾼 채점기의 실행 비용입니다. 더하거나 곱해 전체 운영비 절감률로 사용할 수 없습니다.
Q3. Google Cloud의 OpenAI 모델은 지금 모든 계정에서 쓸 수 있나요?
이번 발표는 일부 기업 대상 시험 제공입니다. 계정의 접근 자격과 실제 지원 기능을 확인해야 합니다. 데이터 비보관 옵션(ZDR)과 처리 중 데이터 보호(Confidential Compute)는 추후 제공으로 안내했습니다.
Q4. 본문 도표와 화면은 직접 생성하거나 실행한 결과인가요?
8장 모두 원문에 게재된 자료이며 신규 생성 이미지는 없습니다. 제작자의 평가표, 제품 화면 예시, 공식 일러스트와 렌더링을 각 캡션에 구분했습니다. 그림이나 ‘원본 확대’를 누르면 고해상도 파일이 열립니다. 이번 원고에서 모델 실행이나 시설 시뮬레이션을 직접 재현한 결과는 아닙니다.
공식 자료와 확인 기준일
확인 기준일: 2026-10-22. 자료 기준 시각은 한국 시각 14시 1분입니다. 기능과 수치는 발표 당시의 제공 단계와 실험 조건을 기준으로 읽어야 합니다.