Graphify Legal Wiki
판례 스캔에서 생성 결과 폴더를 제외하고, 답변이 제공된 근거 ID만 인용하도록 구성했습니다. 자료 입력과 원문 확인의 경계를 다듬은 Graphify Legal Wiki 제작기입니다.
AI Tools Lab · 소개 글 작성 · 수정
그래프를 만들기 전에 입력 문서의 경계를 고쳤습니다
Graphify Legal Wiki에서는 법령과 판례의 참조 관계를 그래프로 만들고, 질문 결과에서 원문을 다시 열 수 있도록 구성했습니다. 관련 문서를 연결하는 도구를 만들면서 먼저 정해야 할 것은 어떤 파일을 원본으로 받아들일지였습니다. 결과를 잘 그리는 일보다 입력의 경계가 앞에 있습니다.
4월 27일에는 판례 문서 스캔에서 생성 결과 폴더와 Git 관리 폴더를 제외했습니다. 판례는 사건 종류와 법원 등급으로 나뉜 경로에서 읽는데, 같은 깊이에 있는 다른 Markdown까지 무조건 포함하면 그래프 산출물이 다시 입력 후보로 들어갈 수 있습니다.
저는 graphify-out과 .git을 제외하는 조건을 명시했습니다. 폴더를 훑어 파일 수를 늘리는 작업을 자료 범위 확대와 같은 의미로 다루지 않았습니다. 원문을 가리키는 관계를 만들려면 입력이 판례인지 생성 결과인지부터 구분할 수 있어야 했습니다.
문서 안의 사건번호와 법령 참조를 나눴습니다
판례 처리에서는 문서의 메타데이터와 본문을 나누고, 본문에서 법령 참조와 사건번호 참조를 추출합니다. 사건번호는 인용 패턴에서 찾고, 여러 번호가 함께 적힌 경우에는 각각의 토큰으로 나눕니다. 법령 이름은 정리한 형태로 집계해 같은 대상을 묶습니다.
두 관계를 한 종류로 합치지 않았습니다. 판례가 어떤 법을 언급하는지와 다른 판례를 인용하는지는 탐색에서 다른 질문이기 때문입니다. 문서 수뿐 아니라 법령 참조와 사건 참조를 별도로 보관하면 어떤 연결을 따라가고 있는지 설명할 수 있습니다.
여기서 추출 규칙이 만드는 결과는 해당 문서에 나타난 참조입니다. 관계가 이어진다는 이유만으로 두 사건의 결론이 같다고 해석하는 기능으로 만들지는 않았습니다. 그래프를 원문 탐색의 통로로 두고, 구체적인 문장을 확인하는 단계는 따로 유지했습니다.
답변에 보낼 근거는 길이와 개수를 제한했습니다
질문 처리에서는 이미 찾은 인용과 근거를 묶어 모델에 전달합니다. 원문 전체를 무조건 보내는 대신 발췌와 관계 설명, 출처 정보의 길이와 개수를 제한했습니다. 입력한 자료 범위를 읽을 수 있도록 답변 문맥을 구성한 선택입니다.
기본 문맥에는 최대 8개 항목과 8,000자 예산을 두고, 항목별 인용에도 상한을 적용했습니다. 이 숫자는 답변 정확도의 성과가 아니라 전송 범위를 정한 설정입니다. 긴 원문을 일부만 보냈다면 답변 역시 그 제한된 발췌 안에서 설명하도록 지시합니다.
인용 ID와 원래 근거의 매핑도 함께 보관합니다. 모델이 반환한 출처를 원문 화면에 연결하려면 출력에 나온 이름만으로 문서를 찾는 방식보다 전달한 항목의 ID를 확인하는 방식이 분명합니다. 제목이 비슷한 문서가 여러 개 있어도 어느 입력을 썼는지 추적할 수 있습니다.
문맥에 없는 인용은 그대로 받아들이지 않았습니다
모델에는 제공한 근거의 ID만 인용하도록 했습니다. 하지만 지시 문장만 넣었다고 출력이 반드시 그 조건을 지킨다고 판단할 수는 없습니다. 응답의 인용이 실제로 전달한 문맥 안에 있는지 확인하고, 맞지 않으면 검증된 인용으로 처리하지 않도록 구성했습니다.
검수 조건에는 문맥에 없는 source_id를 응답으로 돌려주는 경우도 넣었습니다. 이 경우에는 잘못된 인용 상태를 남기고 대체 응답 흐름으로 돌아가도록 합니다. 정상 인용 하나만 확인하면 원문 뷰어가 엉뚱한 출처를 여는 경우를 놓칠 수 있습니다.
또한 법률 자문이나 소송 결과 예측, 행동 권고를 하지 않고 제공한 자료의 요약 범위를 유지하도록 지시합니다. 제가 이 프로젝트에서 만들려는 기능은 질문을 계기로 관련 자료와 근거를 읽는 흐름입니다. 실제 사안의 판단을 그래프 연결이나 생성 문장에 맡기는 구성을 택하지 않았습니다.
검색 결과에서 원문으로 돌아갈 수 있게 했습니다
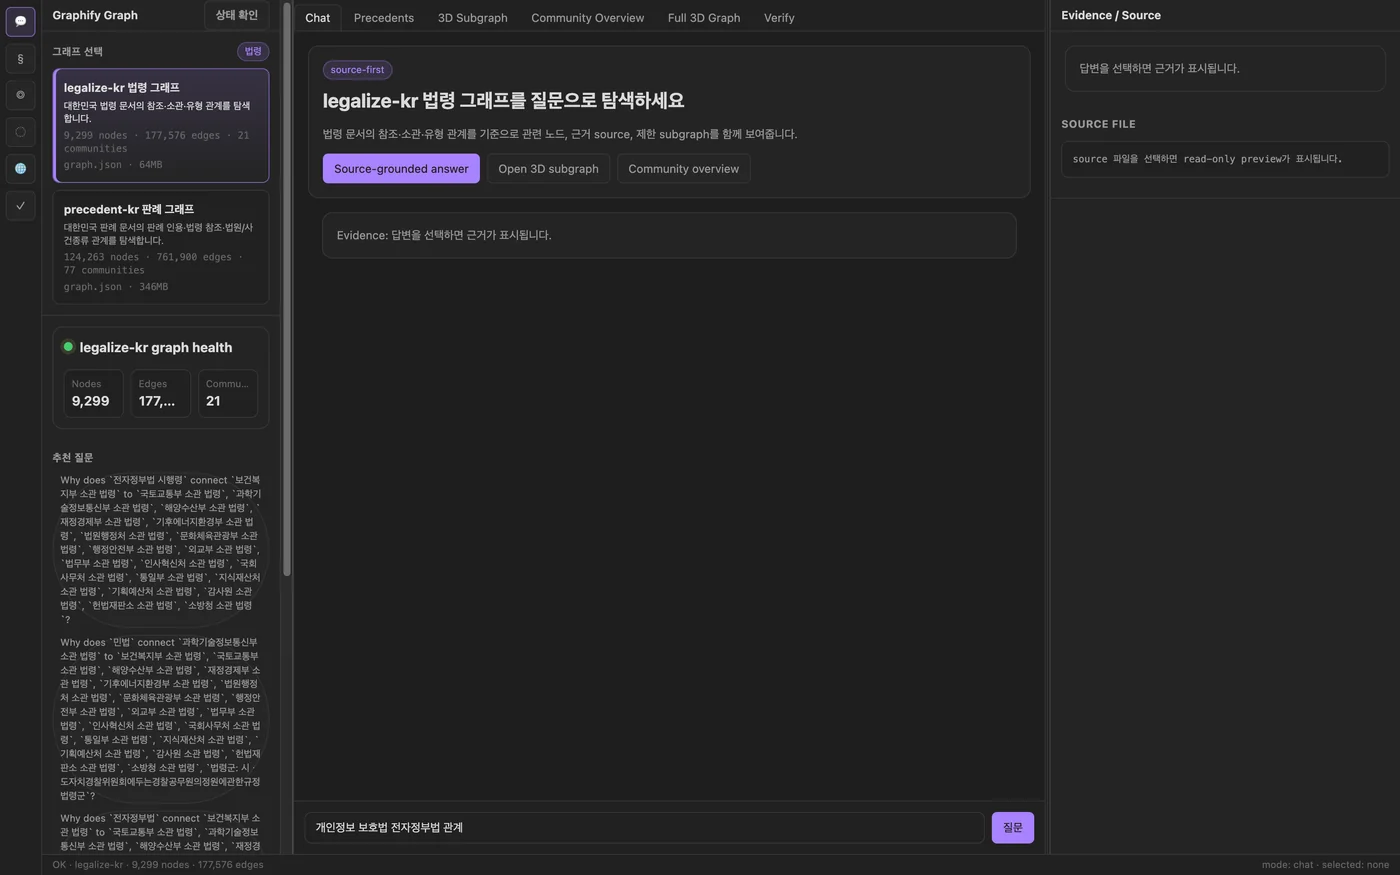
UI에서는 자료 범위 선택, 답변, 근거·원문 뷰어를 나눴습니다. 법령과 판례를 선택한 뒤 질문하거나 그래프를 탐색하고, 결과에 연결된 출처를 열어 본문과 문맥을 확인합니다. 한 화면에 모든 것을 작은 글씨로 넣는 대신 읽는 목적에 따라 영역을 분리했습니다.
원문 경로에도 범위를 뒀습니다. 판례 저장소 밖으로 나가는 상대 경로나 절대 경로를 그대로 열지 않도록 하고, 파일 시스템과 SQLite 인덱스 양쪽에서 같은 경계를 검사하도록 했습니다. 검색 인덱스가 달라져도 원문 읽기 범위는 유지되어야 합니다.
이 구분 덕분에 그래프의 노드나 답변의 인용이 무엇을 가리키는지 다시 살필 수 있습니다. 요약 문장만 복사하고 끝내는 방식보다 입력과 출력 사이를 확인하는 통로를 남긴 것입니다. 자료 수가 늘어나면 이 경로의 일관성도 함께 확인해야 합니다.
자료 탐색 도구는 입력과 출력 양쪽을 좁혀야 합니다
입력에서는 생성한 파일을 원문에 섞지 않고, 출력에서는 모델이 새로 만든 출처를 실제 근거로 받아들이지 않도록 했습니다. 그래프와 답변을 만들기 전에 무엇을 자료와 인용으로 인정할지 정한 것입니다.
비슷한 문서 그래프를 만들 때는 원본 폴더의 모양과 제외할 산출물을 먼저 정하고, 인용 ID가 입력 문맥과 연결되는지 확인하는 편이 좋습니다. 이후 원문 뷰어의 경로와 문서 기준 시점을 확인해야 합니다. 관계를 찾는 성공과 그 내용을 현재의 판단에 적용하는 일은 별도 단계입니다.
Graphify Legal Wiki에서 그래프는 법률 결론을 대신하는 화면이 아니라 자료 사이를 이동하는 화면입니다. 저는 문서 스캔과 답변 문맥, 원문 읽기를 나누면서 각 단계가 무엇을 받아들이는지 설명할 수 있도록 만들었습니다. 근거를 붙이는 것만큼 그 근거가 실제 입력에서 왔는지 확인하는 과정이 중요했습니다.
개발 자료
프로젝트 링크
판례 원문과 생성 산출물, 답변과 제한된 근거의 범위를 나눠 탐색 흐름을 만든 개발 과정입니다.
원본 프로젝트 ↗ · 문의·정정 요청